요약: Black Forest Labs의 7B 로봇 모델 FLUX 3 Action(SO-101 체크포인트)을 RTX 5070 Ti 16GB에서 실행했다. 공식 문서 방식으로는 메모리가 부족했고, 모델 본체(DiT)를 int8로 바꾸자 추론 중 VRAM 9.4GiB 안에서 돌아갔다. 다만 로딩 중에는 13.4GiB까지 쓴다. 행동 32개(1.07초 분량)를 만드는 데 2.34초가 걸려, 30Hz 실시간 제어는 안 된다. 2편에서는 실제 SO-101 녹화 데이터로 예측 품질을 본다.
NVIDIA RoboLab 리더보드에는 이 모델의 GPU 메모리가 69GB로 적혀 있고, 공식 문서에는 권장 VRAM이 없다. 16GB GPU에 들어가는지는 직접 해 봐야 안다. 찾아본 해설 자료 중 소비자용 GPU에서 직접 돌려 본 곳이 없어서 실측했다.
모델 구조(부품 구성, 행동 묶음, DiT 호출 횟수)는 FLUX 3 Action 원리 쉽게 이해하기에 정리했다. 이 글은 그 구조를 16GB GPU에 올리는 과정과 측정값을 다룬다.
SO-101은 Hugging Face의 로봇 학습 라이브러리 LeRobot이 기본으로 지원하는 저가 오픈소스 로봇 팔이다. BFL은 이 팔에 맞춘 FLUX 3 Action 체크포인트(학습된 가중치와 설정 묶음)를 공개했고, 이 글은 그 체크포인트를 쓴다.
단위: 파일 크기는 GB(10억 바이트), 메모리 측정값은 GiB(2^30 바이트)로 적는다. 1GiB는 약 1.07GB다. 그래서 13.9GB 파일이 메모리에서는 12.94GiB가 되고, 16GB 카드에서 PyTorch가 보는 용량은 15.47GiB다.
측정 질문은 두 가지다.
- SO-101 체크포인트가 16GB GPU에 올라가는가?
- 행동 chunk(한 번에 만드는 행동 묶음) 1회 추론이 실시간 기준 안에 끝나는가? SO-101 체크포인트는 행동 42개를 예측해 앞의 32개를 30Hz로 실행하므로(42와 32가 다른 이유) 기준은 32 ÷ 30 = 1.07초다.
1. 준비: 설치에서 막히는 세 곳
① LeRobot은 GitHub main을 써야 한다
PyPI 최신 LeRobot(0.6.1, 8월)에는 FLUX 3 Action 정책이 없다. GitHub main 브랜치에만 있다. 다른 LeRobot 설치와 섞이지 않도록 별도 가상환경을 만들었다. 경로(~/Projects/flux3-test)는 자기 환경에 맞게 바꾸면 된다.
mkdir -p ~/Projects/flux3-test && cd ~/Projects/flux3-test
git clone https://github.com/huggingface/lerobot.git
git -C lerobot checkout b9cb121   # 이 글에서 쓴 main 커밋(2026-10-08). main은 계속 바뀐다
uv venv -p 3.12 .venv
# RTX 50 시리즈: CUDA 13 빌드 torch를 먼저 설치 (LeRobot은 torch 2.12 미만이면 되므로 2.11을 쓴다)
uv pip install --python .venv/bin/python torch==2.11.0 torchvision==0.26.0 \
    --index-url https://download.pytorch.org/whl/cu130
uv pip install --python .venv/bin/python -e "./lerobot[training,flux3,peft,diffusion]"
② NATTEN은 CUDA 버전에 맞는 wheel을 골라야 한다
Video VAE가 NATTEN(neighborhood attention, 주변 영역만 보는 attention을 빠르게 계산하는 CUDA 커널)을 쓴다. 공식 문서 예시는 CUDA 12.8용(cu128)이라, CUDA 13 환경에서는 cu130 wheel을 골라야 한다.
uv pip install --python .venv/bin/python "natten==0.21.6+torch2110cu130" --find-links https://whl.natten.org
설치 후 RTX 5070 Ti(sm_120)에서 neighborhood attention을 단순 참조 구현과 비교하니 오차 0.0005로 정상 동작했다.
③ 가중치는 약 25GB, --include 문법에 주의
SO-101 체크포인트(13.9GB)와, base 저장소(로봇별로 맞추기 전의 기본 모델)에 든 text encoder(Qwen3-VL-4B, 이하 Qwen, 8.9GB)와 Video VAE(2.5GB)가 필요하다. 별도 승인 없이 받을 수 있다.
export HF_HOME=/data/cache/huggingface   # 캐시를 여유 있는 디스크로. 경로는 자기 환경에 맞게
hf download black-forest-labs/flux-3-action-so101 --revision 2d6be04357eef9fb8c8468adbc69e9d0c7093bec
hf download black-forest-labs/flux-3-action-base --revision 62878e2925e59b7a89ec14463ce89932624c490d \
    --include "text_encoder/*" --include video_vae.safetensors
팁:
--include "text_encoder/*" video_vae.safetensors처럼 패턴 하나 뒤에 파일 이름을 이어 쓰면, 뒤의 이름이 별도 파일 인자로 처리되고 include 패턴은 무시됐다. 패턴마다--include를 붙여야 한다.
2. 첫 시도: 공식 방식은 메모리 부족
예상: 문서대로라면 들어간다
공식 문서는 메모리를 줄이는 방법 두 가지를 안내한다.
- 로딩 후 Qwen을 CPU로 옮기면 약 8.3GiB를 아낀다.
- 안 쓰는 image/audio stream을 걸러 DiT 파라미터를 약 28% 줄인다.
둘을 적용하면 GPU에는 DiT(모델 본체인 7B diffusion transformer, 줄어든 크기)와 VAE만 남는다. BF16은 숫자 하나에 2바이트라 7B DiT는 약 14GB(13GiB)다. 여기서 28%를 빼면 약 9.3GiB, VAE를 더해도 12GiB 안팎이라 16GB에 들어갈 것으로 예상했다.
실제: 구성 요소를 재 보니 달랐다
| 구성 요소 | BF16 메모리 (실측, HF 파일 크기와 같음) |
|---|---|
| DiT (7B) | 12.94 GiB |
| Text encoder (Qwen3-VL-4B) | 8.27 GiB |
| Video VAE | 2.34 GiB |
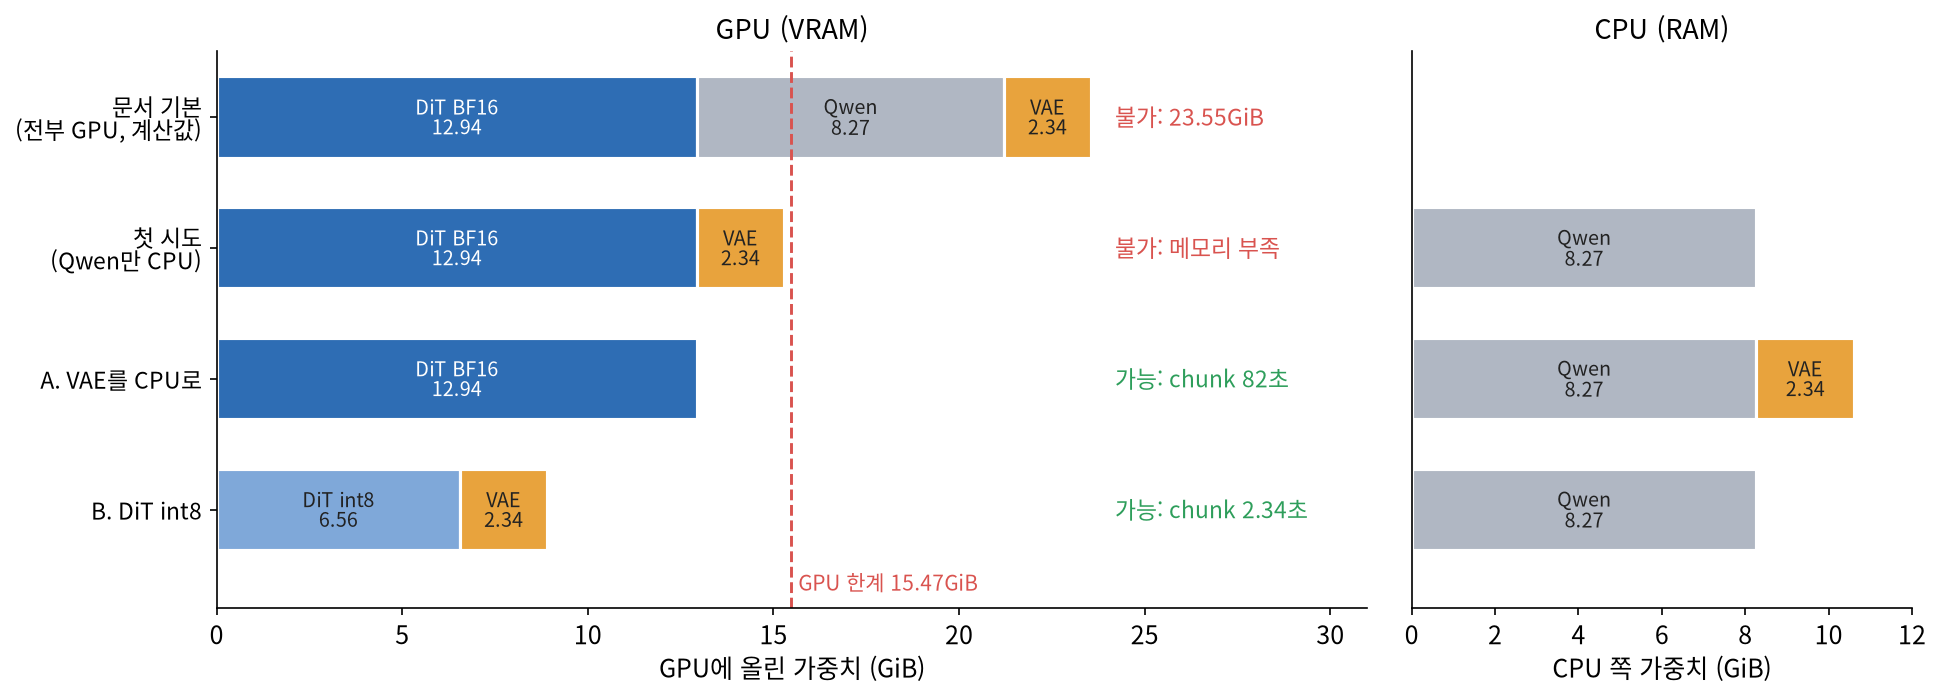
문서대로 그냥 불러오면 Qwen까지 GPU로 올라가므로(아래 원인 3) 세 부품 합계 23.55GiB가 필요해 처음부터 들어갈 수 없다(계산값, 직접 실행하지는 않았다). 그래서 문서 안내에 가장 가깝게 Qwen만 CPU에 두고 DiT와 VAE를 BF16 그대로 GPU에 올려 봤다. 그러자 VAE를 옮기는 중에 메모리 부족(OOM, PyTorch 할당량 14.99GiB 시점)이 났다.
원인: 세 가지가 겹쳤다
- 28% 감소는 이미 적용돼 있었다. 문서의 수치는 base 체크포인트 기준이다. SO-101 체크포인트는 줄어든 구성으로 저장돼 있어서 12.94GiB에서 더 줄지 않았다.
- 계산할 여유가 없다. Qwen을 빼도 DiT + VAE = 15.28GiB다. PyTorch가 보는 GPU 용량(15.47GiB)에서 추론에 쓸 공간이 남지 않는다.
- 로딩 순간의 peak는 피할 수 없다. 모델을 불러오는 함수
from_pretrained는 정책 설정의device값으로 Qwen까지 정책 전체를 옮긴다(pretrained.py). SO-101 체크포인트의config.json에는 이 값이"cuda"로 저장돼 있다. 그래서 "불러온 뒤 Qwen을 CPU로 옮기기"로는 불러오는 순간의 peak를 피할 수 없다. 3절 코드에서cfg.device = "cpu"로 설정값을 먼저 바꾸는 이유다.
3. 해결: 두 가지 선택지
GPU에 올릴 것을 줄이는 방법은 두 가지다.
| 선택지 | 방법 | 결과 (4절) |
|---|---|---|
| A. VAE를 CPU로 | DiT는 BF16 그대로 GPU, VAE와 Qwen은 CPU | 들어간다. 하지만 chunk마다 카메라 영상을 압축하는 VAE 인코딩이 CPU에서 80초 걸린다 |
| B. DiT를 int8로 | DiT 가중치를 int8로 저장해 절반 크기로(weight-only, 계산은 BF16). VAE는 GPU, Qwen은 CPU | 들어가고 chunk 1회 2.34초 → 채택 |
로딩 순서 바꾸기 (B)
모델 코드는 DiT, VAE, Qwen을 모두 CPU에서 만든 뒤 마지막에 한꺼번에 GPU로 옮긴다. 그래서 옮기기 직전에 text encoder와 VAE를 잠시 빼 두면 DiT만 먼저 올릴 수 있다.
LeRobot 코드는 수정하지 않는다. 아래 코드는 별도 파이썬 파일(예: run_int8.py)에 작성해, 설치한 LeRobot을 라이브러리로 불러 쓴다. 불러온 정책 객체에서 부품을 잠시 떼었다 붙이고, DiT만 그 자리에서 int8로 바꾼다.
import torch
from lerobot.configs.policies import PreTrainedConfig
from lerobot.policies.flux3 import Flux3Policy
from torchao.quantization import Int8WeightOnlyConfig, quantize_

ckpt = "black-forest-labs/flux-3-action-so101"
cfg = PreTrainedConfig.from_pretrained(ckpt)
cfg.device = "cpu"                                   # 1) 전부 CPU에 로드 (RAM peak 약 30GiB)
policy = Flux3Policy.from_pretrained(ckpt, config=cfg).eval()

# policy.frozen: 학습하지 않는 부품(Qwen, VAE)을 모아 둔 곳
te, vae = policy.frozen.text_encoder, policy.frozen.video_vae
policy.frozen.text_encoder = torch.nn.Identity()    # 2) 옮기는 동안 잠시 빼 둔다
policy.frozen.video_vae = torch.nn.Identity()
policy.config.device = "cuda"                        #    추론은 GPU에서 하도록 설정도 되돌린다
policy.to("cuda")                                    #    → DiT(12.94GiB)만 GPU로
policy.frozen.text_encoder = te                      #    Qwen은 CPU에 남는다

skip = ("final_layer", "time_in")                    # 3) GPU에서 int8 weight-only 변환
quantize_(policy.dit, Int8WeightOnlyConfig(),
          filter_fn=lambda m, fqn: isinstance(m, torch.nn.Linear) and not any(s in fqn for s in skip))
torch.cuda.empty_cache()

vae.module.to("cuda")                                # 4) 이제 VAE를 GPU로 (.module = 래퍼 안의 실제 VAE 모델)
policy.frozen.video_vae = vae
final_layer와 time_in을 빼는 이유가 있다. 모델 코드가 이 층의 가중치를 직접 꺼내 .weight.chunk(2)처럼 쓰는데, int8 텐서는 이 연산을 지원하지 않아 추론 중 NotImplementedError가 났다. 이 두 작은 층만 BF16으로 남기면 동작한다.
추론 호출
로딩이 끝나면 LeRobot 문서의 방식대로 전처리 → 추론 → 후처리를 제어 주기마다 호출한다. observation은 다음 키를 담은 dict다(SO-101 체크포인트 config.json의 입력 정의).
observation.images.scene: 위에서 보는 장면 카메라 영상 (3×256×256)observation.images.wrist: 손목 카메라 영상 (3×256×256)observation.state: 관절 6개의 현재 상태task: 지시문 문자열
from lerobot.policies.factory import make_pre_post_processors

preprocessor, postprocessor = make_pre_post_processors(policy.config, pretrained_path=ckpt)

# 제어 주기(30Hz)마다 호출. 행동이 남아 있으면 바로 꺼내고, 비면 새 chunk를 계산한다
prepared = preprocessor(observation)
normalized_action = policy.select_action(prepared)
command = postprocessor(normalized_action)       # 정규화를 풀어 실제 관절 명령으로 되돌린 값
이 글의 시간 측정은 전처리를 마친 형식의 입력으로 policy.predict_action_chunk(batch)를 직접 불러 chunk 1회 시간을 쟀다. 처음 1회는 준비 실행으로 빼고, 이어서 잰 값을 평균했다(측정 횟수는 4절 표 참고).
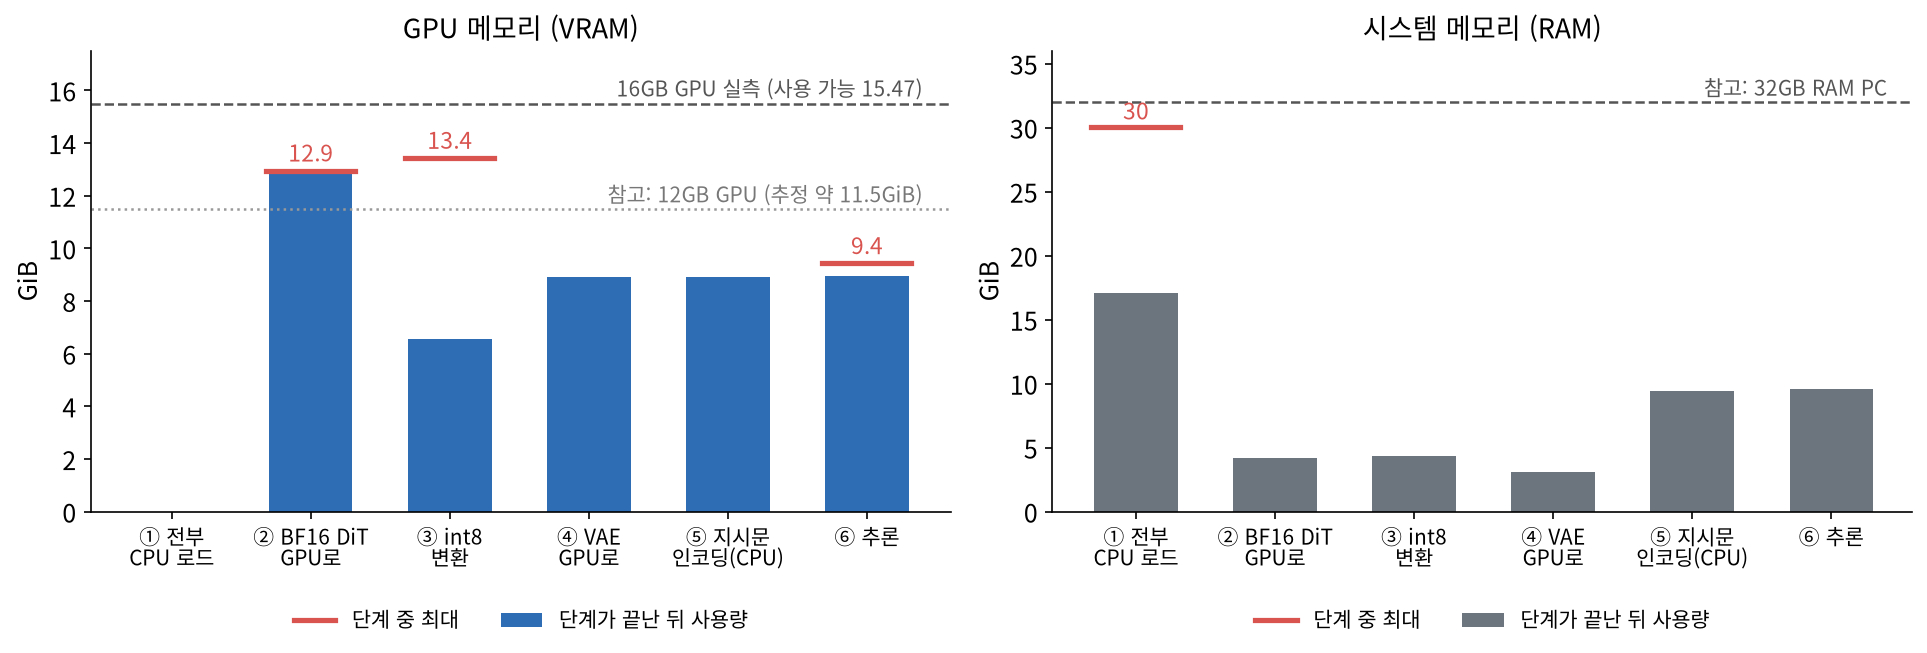
단계별 메모리
4. 측정 결과
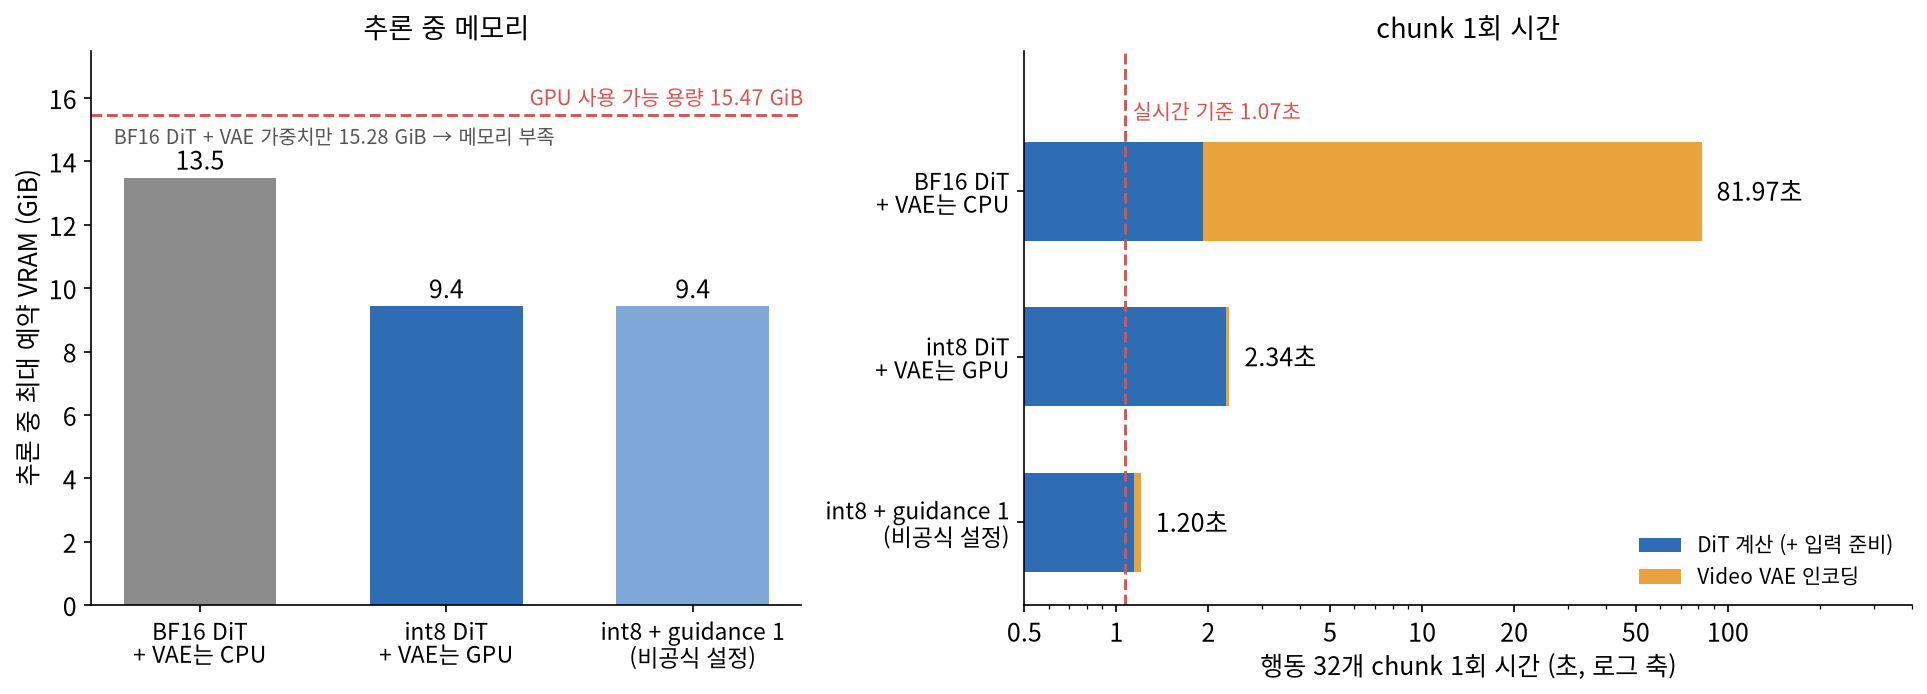
입력은 전처리를 마친 형식의 합성 데이터(카메라 2대 × 8프레임, 상태·과거 명령 8스텝, 지시문 1개)다. 텐서 크기가 고정이라 메모리와 시간은 입력 값과 무관하다. 예측 품질은 2편에서 실제 데이터로 본다.
| 구성 | 16GB | 추론 중 최대 VRAM | chunk 1회 (측정 횟수) | 실시간 기준(1.07초)의 몇 배 |
|---|---|---|---|---|
| BF16, Qwen만 CPU (2절의 첫 시도) | ❌ OOM | — | — | — |
| A. BF16 DiT + VAE를 CPU로 | ✅ | 13.5GiB | 82초 (5회) | 77배 |
| B. int8 DiT + VAE GPU | ✅ | 9.4GiB | 2.34초 (3회) | 2.2배 |
| B + guidance 1 (비공식 설정) | ✅ | 9.4GiB | 1.20초 (5회) | 1.1배. 출력이 공식 설정과 다름(평균 차이가 출력 표준편차의 20%, 5절 ④) |
B + compile_model=true |
✅ | 9.4GiB | 188초 | 원인 미확인으로 크게 느려짐 |
표의 VRAM은 PyTorch가 잡아 둔 양(reserved)이다. nvidia-smi로 보면 CUDA 기본 메모리가 더해져 B 구성이 약 9.9GiB로 보인다.
로딩 중 peak와 추론 중 peak는 다르다
| B 구성 | 로딩 중 최대 | 추론 중 최대 |
|---|---|---|
| VRAM | 13.4 GiB (③ int8 변환 중) | 9.4 GiB |
| RAM | 30 GiB (① CPU 로드 중) | 약 9.6 GiB |
"추론 중 9.4GiB"만 보면 12GB GPU에도 들어갈 것 같지만, 이 순서로는 로딩 단계에서 VRAM이 13.4GiB까지 오른다. 12GB 카드에서 직접 재 보지는 않았다.
B 구성의 세부 값
- 로딩: CPU 로드 약 55초, int8 변환 0.6초
- 지시문 인코딩: CPU의 Qwen이 지시문과 빈 문자열(guidance용)을 처리하는 데 약 92초. 지시문마다 한 번만 하고 이후 캐시된다. 실제로 쓰면 새 지시를 줄 때마다 첫 동작까지 1분 반가량 기다린다는 뜻이다
- chunk 3회: 2.335~2.345초로 편차가 거의 없다. 그중 VAE는 0.06초이고, 나머지 2.28초가 DiT다
- guidance는 지시를 더 잘 따르게 하려고, 지시문을 넣은 계산과 빈 지시문 계산의 차이를 키우는 기법(classifier-free guidance)이다. 체크포인트 설정이 euler 4 step, guidance 3/3(영상·행동)이라 chunk 1회에 DiT를 8번 호출한다. 단계마다 지시문을 넣은 계산과 빈 지시문 계산을 한 번씩 하기 때문이다(2회 × 4 step). DiT 호출 1회당 약 0.29초다
5. 해석
① 질문 1의 답: 16GB에는 올라간다. 로딩 순서를 바꾸고 DiT를 int8로 줄이면 추론 중 9.4GiB라 여유가 6GiB쯤 남는다. 다만 두 가지 조건이 붙는다.
- 로딩 중 VRAM이 13.4GiB까지 오른다. 12GB GPU의 전체 용량보다 크므로 이 순서 그대로는 부족할 것이다(12GB 카드에서 직접 확인하지는 않았다). int8 변환을 CPU에서 먼저 하면 이 peak를 낮출 수 있을 것으로 보이지만 시험하지 않았다.
- 로딩할 때 RAM을 30GiB까지 쓴다. 32GB RAM PC는 OS와 다른 프로그램이 쓰는 몫을 빼면 남는 양이 이보다 적을 수 있어 빠듯할 것으로 보인다. 32GB 환경에서 실행해 보지는 않았다.
② 질문 2의 답: 실시간 제어는 안 된다. chunk 1회가 2.34초로 기준(1.07초)의 2.2배다. 게다가 LeRobot에는 비동기 추론(로봇이 움직이는 동안 다음 chunk를 미리 계산)과 RTC(real-time chunking, 실행 중인 chunk와 새 chunk를 이어 붙이는 기법)가 있지만, FLUX 3 Action 정책은 아직 둘 다 지원하지 않아 동기 실행만 된다(b9cb121 기준). 문서에도 "RTC/asynchronous inference is not supported"라고 적혀 있고, 비동기 추론 지원 목록(async_inference/constants.py)에도 없다. 그래서 로봇은 행동 32개(1.07초)를 실행한 뒤, 다음 chunk를 계산하는 2.34초 동안 멈춘다. 한 주기 3.41초 중 움직이는 시간은 31%다. 비동기 실행이 지원되면 실행 중에 다음 chunk를 미리 계산하므로, 정지는 약 1.3초(2.34 − 1.07)로 줄어든다.

③ 메모리 문제를 해결해도 속도 문제는 남는다. 병목은 DiT 계산이다. A 구성의 BF16 DiT 계산 시간은 1.92초로 B의 int8(2.28초)보다 빨랐지만(VAE 시간 제외) 그래도 기준의 1.8배다. int8 weight-only는 가중치를 int8로 저장했다가 계산할 때마다 BF16으로 되돌리는(dequantize) 과정이 붙어, 메모리는 절반이 되는 대신 오히려 약 19% 느려졌다.
④ 줄일 수 있는 곳은 호출 수다. guidance를 1로 낮추면 DiT 호출이 절반이 돼 1.20초까지 줄지만, 공식 문서가 제시한 설정(3/3, 4/1)이 아니고 출력도 크게 달라진다(같은 입력에서 평균 차이가 출력 표준편차의 20%). 성능 보장이 없는 설정이다.
⑤ int8로 바꿔도 출력은 크게 달라지지 않았다. 같은 합성 입력에서 int8과 BF16 출력의 평균 차이는 출력 표준편차의 3.3%였다. 모델이 직접 내는 정규화된 값 기준으로 팔 관절 최대 차이는 0.05였지만, 그리퍼 한 지점에서 0.32 차이가 났다. 비교 기준인 BF16은 VAE를 CPU에서 돌린 결과라 차이가 전부 int8 때문이라고 단정할 수는 없다.
6. 정리
- RTX 5070 Ti 16GB에서 FLUX 3 Action SO-101 정책은 로딩 순서 변경 + DiT int8로 돌아간다. VRAM은 추론 중 9.4GiB, 로딩 중 13.4GiB, RAM은 로딩 중 30GiB가 필요하다.
- chunk 1회 2.34초라 이 GPU에서는 오프라인 평가나 느린 시연용이다. 실제 SO-101을 실시간으로 움직이려면 더 빠른 GPU와 비동기 실행(RTC) 지원이 함께 필요하다. 동기 실행에서는 GPU가 빨라져도 추론 시간만큼 매번 멈추기 때문이다.
- 실제 팔에 올릴 때는 안전 장치를 따로 둬야 한다. 모델은 관절 속도, 힘, 작업 범위를 제한하지 않는다. 관절 제한과 비상 정지는 바깥 프로그램에서 직접 구현해야 한다.
한계
- 입력이 합성 데이터라 예측 품질은 보지 않았다(2편에서 다룬다).
- 실제 로봇 없이 측정했다. 카메라 읽기, 서보 통신 같은 실제 제어 루프의 지연은 들어 있지 않다.
- BF16 비교 기준은 VAE를 CPU에서 돌린 결과다.
compile_model=true가 188초나 걸린 원인은 확인하지 못했다.
다음에 해 볼 것
- 2편: 이 int8 구성으로 공개 SO-101 녹화 데이터에서 예측이 얼마나 맞는지 본다.
- int8 변환을 CPU에서 먼저 해 로딩 중 VRAM peak를 낮출 수 있는지 확인한다.
- LeRobot에서 FLUX 3 Action의 비동기 추론이나 RTC가 지원되면 다시 측정한다.
환경
- GPU RTX 5070 Ti 16GB / CPU Ryzen 5 2600 / RAM 64GB / ASUS A320M (PCIe 3.0) / Ubuntu 24.04
- torch 2.11.0+cu130, LeRobot main
b9cb121(2026-10-08), natten 0.21.6+torch2110cu130, torchao 0.18.0, transformers 5.5.4 - 체크포인트:
black-forest-labs/flux-3-action-so101리비전2d6be043, base 리비전62878e29(2026-10-12 기준)
참고
- FLUX 3 Action 원리 쉽게 이해하기 (이 블로그의 구조 해설)
- Black Forest Labs, FLUX 3 Action 발표 블로그 (Hugging Face)
- Black Forest Labs, flux-3-action-so101 모델 카드 / GitHub flux-action
- LeRobot, FLUX 3 Action 문서
- NATTEN wheel: https://whl.natten.org
- torchao: https://github.com/pytorch/ao
- NVIDIA, RoboLab 리더보드 (69GB 기재, 2026-10-12 확인)